
Story Time: Cómo terminé descubriendo que mis agentes de IA estaban llevando mi laptop al límite y que el problema no era precisamente Claude Code.
Últimamente he estado experimentando bastante con agentes de inteligencia artificial para el desarrollo de software. Y es que, si lo pensamos un poquito, la posibilidad de tener varios agentes trabajando en diferentes tareas de un mismo proyecto es algo que hace unos años hubiera parecido una locura.
Imagínate tener a un desarrollador trabajando en el frontend, otro en el backend, uno más escribiendo pruebas y otro revisando errores. Todo al mismo tiempo y sin necesidad de estar pendiente de cada línea de código.
Bueno, esa era más o menos la idea que tenía en mente.
Para conseguirlo empecé a utilizar herdr, una herramienta que me permite gestionar varias sesiones de agentes de IA desde la terminal. En mi caso utilizo Claude Code, aunque este tipo de flujo también se puede conseguir con otros agentes y herramientas como tmux.
Lo interesante de todo esto es que cada agente puede trabajar en su propio git worktree.
¿Y qué es un worktree? Básicamente, Git nos permite tener varios directorios de trabajo asociados a un mismo repositorio. De esa manera, puedo tener un agente desarrollando una funcionalidad y otro corrigiendo un error, cada uno en su propio espacio, sin que ambos estén modificando directamente los mismos archivos.
Hasta ahí todo muy bonito.
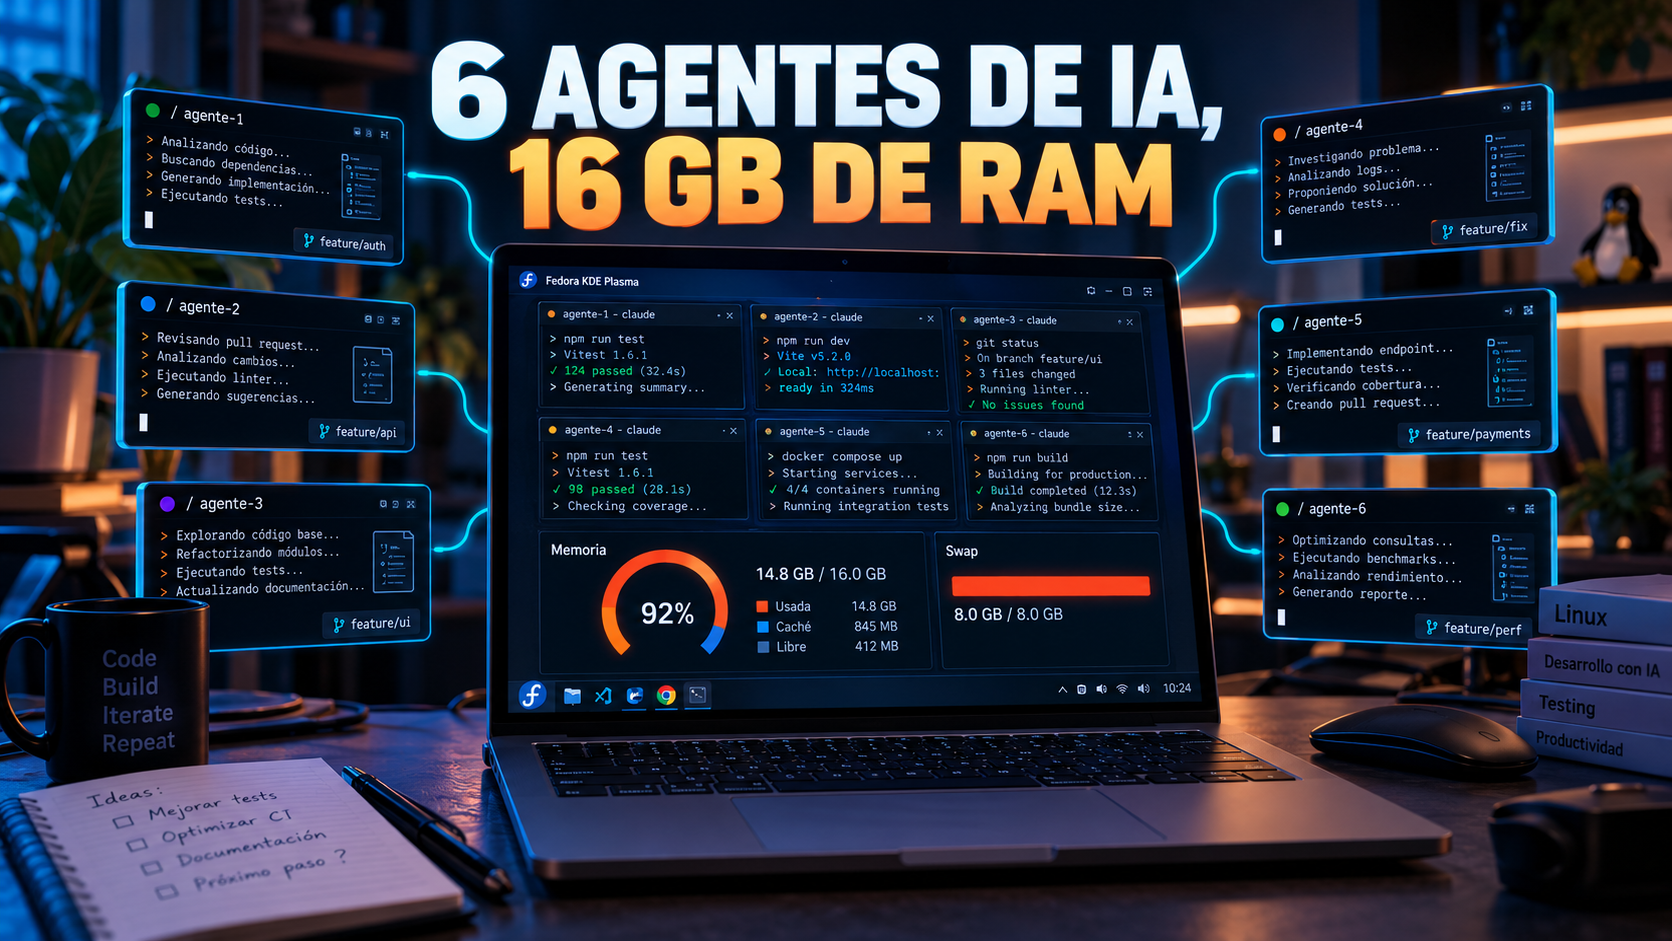
Tenía aproximadamente 6 agentes abiertos, algunos trabajando en el frontend, otros en el backend y otros ejecutando pruebas para verificar que los cambios realizados funcionaran correctamente.
Y yo feliz, porque sentía que estaba aprovechando mucho mejor mi tiempo.
Pero había un pequeño problema.
MI LAPTOP SE ESTABA QUEDANDO SIN RAM.
Y no hablo de que estuviera un poquito lenta. Hablo de que la memoria llegaba prácticamente al 100 %, las aplicaciones comenzaban a sufrir y algunos procesos simplemente desaparecían.
Mi laptop tiene un procesador Intel Core Ultra 5 225H, con 14 núcleos lógicos y aproximadamente 15 GB de RAM utilizables. Utilizo Fedora Linux 44 con KDE Plasma, sobre Wayland, y tengo configurados otros 8 GB de swap mediante zram.
En teoría, pensaba que debería ser suficiente para trabajar con varias sesiones de Claude Code. Después de todo, no estaba levantando seis máquinas virtuales ni seis entornos de desarrollo completos.
Así que mi primera sospecha fue bastante obvia.
¿Será que Claude Code consume demasiada memoria? ¿Será herdr? ¿O simplemente me estaba emocionando demasiado abriendo agentes?
No tenía idea.
Y como tampoco quería resignarme a utilizar solamente dos agentes o comenzar a cerrar aplicaciones al azar, decidí investigar qué estaba pasando realmente.
El primer indicio: Linux estaba matando mis procesos
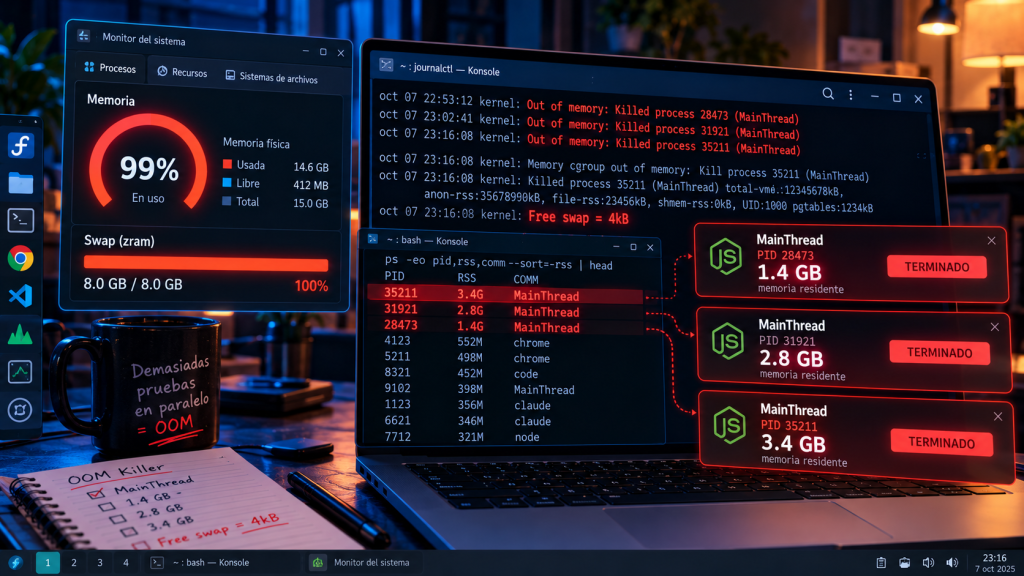
El 7 de octubre, entre las 10:53 y las 11:16 de la noche, ocurrió algo que terminó dándome una pista bastante importante.
Revisando los registros del sistema encontré que Linux había activado tres veces un mecanismo llamado OOM killer.
¿Y qué rayos es eso?
Bueno, OOM significa Out Of Memory, que en español vendría a ser algo así como «sin memoria disponible».
Cuando Linux se encuentra en una situación en la que no puede satisfacer las solicitudes de memoria de los procesos, puede tomar una decisión bastante drástica: matar algunos de ellos para intentar mantener el sistema funcionando.
Sí, literalmente decide qué proceso sacrificar.
Y eso fue exactamente lo que ocurrió.
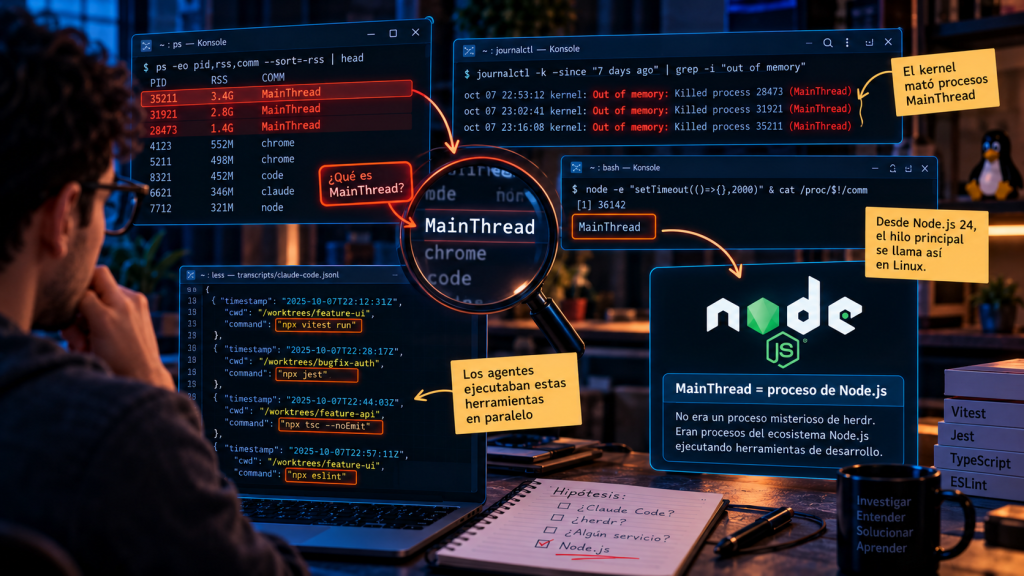
Lo curioso era que los procesos que estaba matando aparecían con un nombre bastante particular: MainThread.
Uno de ellos estaba utilizando aproximadamente 1,4 GB de memoria residente, otro 2,8 GB y otro 3,4 GB.
¿MainThread? ¿Qué demonios era eso?
Al principio pensé que podría tratarse de algún proceso interno de herdr o tal vez de alguna aplicación que había dejado ejecutándose sin darme cuenta.
Pero había algo todavía más preocupante.
En el último evento OOM, Linux reportaba que de los 8 GB de swap prácticamente no quedaba nada.
Free swap = 4kB.
O sea, no solamente me había quedado sin memoria disponible, sino que también había agotado prácticamente toda la swap.
Y aquí vale la pena explicar algo.
En Linux podemos utilizar una tecnología llamada zram, que permite almacenar páginas de memoria comprimidas dentro de la propia RAM.
En mi caso tenía configurados 8 GB de swap con zram, utilizando el algoritmo de compresión lzo-rle. No tenía swap adicional en disco.
Esto no significa que mágicamente tenga 23 GB de RAM física. Lo que ocurre es que Linux puede comprimir ciertos datos para aprovechar mejor la memoria disponible.
Pero claro, si los procesos siguen solicitando memoria y ni siquiera comprimiendo conseguimos suficiente espacio, tarde o temprano el sistema se queda sin alternativas.
Y aparentemente yo había llegado a ese punto.
NECESITABA SABER QUÉ ESTABA CONSUMIENDO TANTA MEMORIA.
Empecemos por lo básico: ¿quién se está comiendo mi RAM?
Lo primero que hice fue revisar el estado de la memoria utilizando algunos comandos bastante conocidos de Linux.
Abrí mi terminal y ejecuté:
free -h
swapon --show
zramctl
El primero, free -h, nos permite conocer cuánta memoria tenemos disponible, cuánta está siendo utilizada y cómo se encuentra la swap.
El segundo nos muestra los dispositivos de swap activos.
Y el tercero nos permite revisar la configuración de zram, incluyendo el algoritmo de compresión y la memoria que está utilizando.
Hasta ahí todo bien. Ya sabía cómo estaba distribuida mi memoria, pero todavía no sabía quién estaba consumiéndola.
Así que continué con:
ps -eo pid,rss,comm --sort=-rss | headEste comando muestra los procesos ordenados por la cantidad de memoria residente que utilizan.
La memoria residente, o RSS, representa las páginas de memoria física asociadas a un proceso. Es una métrica bastante útil para encontrar aplicaciones pesadas, aunque debemos recordar que parte de esa memoria puede estar compartida con otros procesos.
Y aquí comenzaron a aparecer procesos con consumos bastante elevados.
Pero había un inconveniente: yo estaba investigando algo que ya había ocurrido.
Por lo tanto, revisar únicamente los procesos actuales no era suficiente. Necesitaba saber qué estaba ejecutándose exactamente cuando Linux decidió comenzar a matar procesos.
Afortunadamente, Linux registra bastante información sobre estos eventos.
Ejecuté:
journalctl -k --since "7 days ago" | grep -i "out of memory"Este comando consulta los registros del kernel y busca los mensajes relacionados con falta de memoria.
Después revisé las tablas de procesos que el kernel había registrado durante los eventos OOM.
Y ahí estaban nuevamente.
Los famosos MainThread.
El misterio de MainThread
Aquí fue donde la investigación comenzó a ponerse interesante.
Resulta que desde Node.js 24, el hilo principal de ejecución puede aparecer identificado como MainThread en Linux.
¿Node.js?
Eso ya tenía mucho más sentido.
Mi proyecto principal es un monorepo que utiliza React, Vite y TypeScript en el frontend, y NestJS en el backend.
Es decir, buena parte de las herramientas de desarrollo que utilizo funcionan sobre Node.js.
Pero tampoco quería quedarme únicamente con esa explicación. Así que decidí comprobarlo.
Ejecuté:
node -e "setTimeout(()=>{},2000)" & cat /proc/$!/commY el resultado fue:
MainThread¡AHÍ ESTABA!
No se trataba de algún proceso misterioso de herdr. Estaba viendo procesos relacionados con Node.js.
Pero ojo, esto no significaba que Node.js fuera el culpable.
Un servidor NestJS puede funcionar perfectamente utilizando entre 100 y 200 MB de memoria en determinados proyectos, mientras que un servidor de desarrollo de Vite puede mantenerse aproximadamente entre 200 y 500 MB.
Entonces, ¿por qué tenía procesos de Node.js consumiendo varios gigabytes?
La respuesta estaba en algo que hasta ese momento no había considerado suficientemente.
¿Qué comandos estaban ejecutando mis agentes mientras yo trabajaba en otras cosas?
Los agentes estaban trabajando demasiado bien
Una de las cosas interesantes de Claude Code es que conserva registros de sus conversaciones y acciones en archivos JSONL.
Estos archivos permiten reconstruir los comandos que ejecutaron los agentes durante una sesión.
Así que decidí revisar qué había ocurrido durante la franja horaria en la que Linux comenzó a matar procesos.
Y encontré algo bastante curioso.
Mientras yo tenía varios agentes trabajando en sus respectivos worktrees, algunos estaban ejecutando comandos como estos:
npx vitest run
npx jest
npx tsc --noEmit
npx eslint
A simple vista, ninguno de esos comandos tiene nada de extraño.
De hecho, son exactamente las herramientas que uno esperaría que utilizara un agente responsable.
Si modifica el frontend, ejecuta pruebas con Vitest.
Si modifica el backend, ejecuta Jest.
Si quiere verificar los tipos de TypeScript, utiliza tsc.
Y si necesita validar las reglas de calidad del código, ejecuta ESLint.
Hasta ahí todo perfecto.
El problema era que varios agentes estaban haciendo estas verificaciones al mismo tiempo, sin saber lo que estaban ejecutando los demás.
Algunos incluso lanzaban pruebas sobre carpetas completas y archivos relacionados con coverage.
Y fue entonces cuando decidí revisar la configuración de Vitest.
Abrí mi archivo vitest.config.ts y encontré que no había establecido límites explícitos para la cantidad de workers.
¿Workers?
Aquí es donde tenemos que entender cómo funcionan internamente estas herramientas.
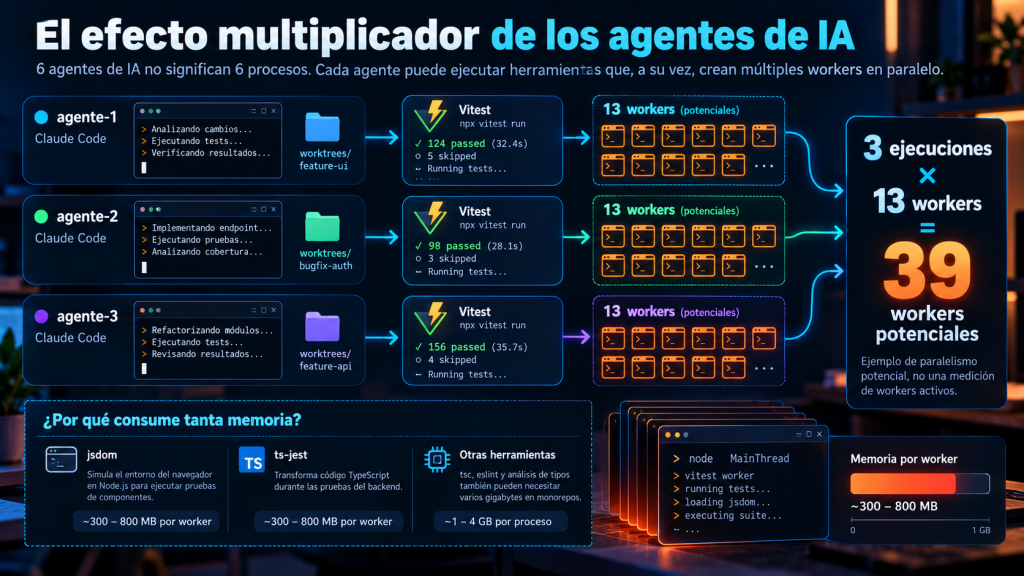
El verdadero problema: 6 agentes no significan 6 procesos
Cuando ejecutamos una herramienta como Vitest o Jest, no necesariamente estamos iniciando un único proceso que ejecuta todas las pruebas una detrás de otra.
Estas herramientas pueden distribuir el trabajo entre varios workers, que son unidades de ejecución independientes utilizadas para procesar tareas en paralelo.
La idea es bastante buena.
Si tienes un procesador con varios núcleos, ¿por qué no aprovecharlos para ejecutar más pruebas al mismo tiempo?
El problema aparece cuando cada herramienta intenta aprovechar esos recursos sin considerar que hay otras herramientas haciendo exactamente lo mismo.
Mi procesador tiene 14 núcleos lógicos.
En el escenario que estaba investigando, las configuraciones de paralelismo podían llegar a utilizar aproximadamente 13 workers por ejecución, aunque la cantidad efectiva depende de la versión, el pool y la configuración de cada herramienta.
Ahora imagínate que tres agentes ejecutan Vitest simultáneamente.
Tenemos algo así:
3 ejecuciones de Vitest × 13 workers = 39 workers potenciales.
¡TREINTA Y NUEVE!
Y eso sin contar los demás agentes, los servidores de desarrollo, TypeScript, ESLint o las aplicaciones que ya estaban funcionando en mi laptop.
Pero había otro detalle.
En el frontend utilizo Vitest con jsdom.
jsdom es una biblioteca que simula parte del entorno de un navegador dentro de Node.js, permitiendo ejecutar pruebas de componentes y código frontend sin necesidad de abrir Chrome.
El inconveniente es que estos entornos necesitan memoria.
En cargas como la mía, cada worker de Vitest con jsdom o Jest con ts-jest podía llegar a consumir aproximadamente entre 300 y 800 MB.
Por supuesto, eso no significa que todos los workers estuvieran consumiendo 800 MB simultáneamente, pero sí demuestra el riesgo de permitir que se multipliquen sin control.
Y mientras tanto, otros agentes podían ejecutar tsc --noEmit o ESLint con reglas que necesitan analizar los tipos del proyecto.
En monorepos grandes, estos procesos pueden necesitar entre 1 y 4 GB de memoria, dependiendo del tamaño y la configuración.
Ahora sí comenzaba a entender qué estaba pasando.
No tenía seis agentes consumiendo memoria. Tenía seis agentes con la capacidad de lanzar decenas de procesos adicionales.
Y ninguno estaba coordinándose con los demás.
Pero había otro detalle escondido en el backend
Mientras revisaba los scripts del proyecto encontré algo que tampoco ayudaba demasiado.
Uno de los comandos utilizados para ejecutar pruebas con cobertura tenía configurada esta variable:
NODE_OPTIONS=--max-old-space-size=8192Para entender por qué esto es importante, tenemos que hablar brevemente de V8.
V8 es el motor de JavaScript utilizado por Node.js. Una de sus responsabilidades es administrar la memoria donde se almacenan los objetos de JavaScript.
A esa región administrada se le conoce como heap.
Mediante --max-old-space-size podemos establecer un límite para una parte importante de ese heap, expresado en megabytes.
En este caso, el script estaba permitiendo un límite de aproximadamente 8 GB.
¡OCHO GIGABYTES!
Y aunque eso no significa que el proceso vaya a consumirlos obligatoriamente, sí le permite crecer considerablemente antes de alcanzar ese límite.
Además, el heap no representa toda la memoria de un proceso Node.js. También existen buffers, stacks y memoria nativa.
El detalle más importante era que ese script establecía su propio NODE_OPTIONS, por lo que podía reemplazar cualquier valor global que yo intentara configurar desde fuera.
Es decir, podía establecer un límite general de 2 GB para mis agentes, pero si alguno ejecutaba ese script, terminaría utilizando la configuración definida por el propio proyecto.
Otro problema más para la lista.
Entonces, ¿cuánto estaba consumiendo realmente Claude Code?
Esta fue probablemente la parte que más me sorprendió.
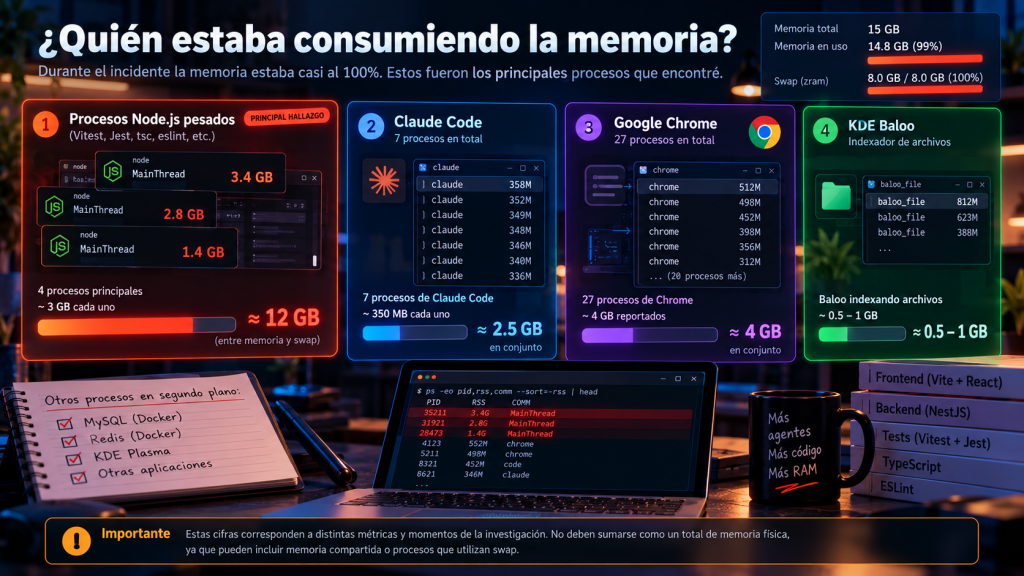
Cuando revisé los procesos del incidente encontré aproximadamente siete procesos de Claude Code, cada uno utilizando alrededor de 350 MB.
En conjunto representaban unos 2,5 GB.
No era un consumo despreciable, evidentemente, pero tampoco explicaba por sí solo lo que estaba ocurriendo.
En cambio, encontré cuatro procesos Node pesados, de aproximadamente 3 GB cada uno, que representaban alrededor de 12 GB entre memoria y swap.
También tenía Chrome ejecutando 27 procesos, con un consumo aproximado de 4 GB.
Y para completar el panorama, Baloo, el indexador de archivos de KDE Plasma, estaba utilizando entre 500 MB y 1 GB mientras indexaba aproximadamente 200.000 archivos, incluyendo directorios node_modules.
¡HASTA MI INDEXADOR ESTABA TRABAJANDO DE MÁS!
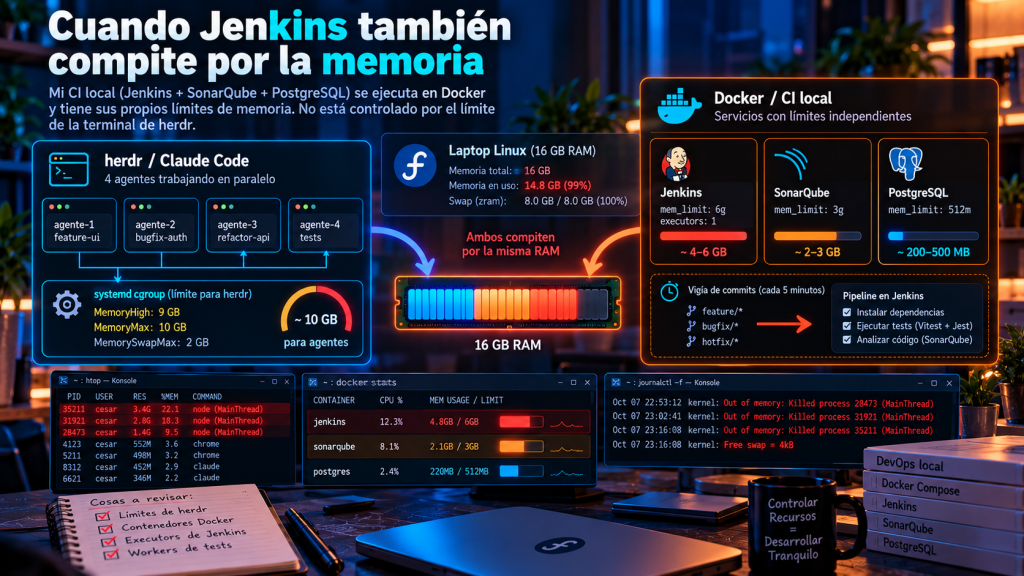
Por cierto, también tengo un entorno de integración continua local utilizando Jenkins, SonarQube y PostgreSQL mediante Docker.
Sin embargo, esa noche Jenkins y SonarQube estaban apagados, así que no participaron directamente en el incidente.
Lo menciono porque más adelante encontré que también representaban un riesgo importante si llegaban a ejecutarse junto con los agentes.
A estas alturas ya tenía bastante clara la situación.
El problema no era Claude Code, tampoco herdr y mucho menos un fallo de mi laptop.
El problema era la combinación de herramientas con paralelismo automático, procesos pesados y varios agentes ejecutándolos sin ningún tipo de coordinación.
Bueno, ya sabía qué estaba pasando.
Ahora venía la siguiente pregunta.
¿Cómo podía seguir trabajando con varios agentes sin que mi laptop terminara muriendo cada vez que ejecutaban pruebas?
Primera solución: ponerle un presupuesto de memoria a herdr
Lo primero que quería conseguir era bastante sencillo.
No quería que mis agentes pudieran utilizar toda la memoria disponible de mi laptop.
Si tenía aproximadamente 15 GB de RAM utilizables, me parecía razonable reservar una parte para Fedora, KDE, Chrome y los demás procesos del sistema.
Así que decidí establecer un presupuesto de memoria para herdr.
Y aquí apareció una tecnología bastante interesante de Linux: cgroups.
Los control groups, o cgroups, permiten organizar procesos y establecer restricciones sobre los recursos que pueden utilizar, incluyendo CPU y memoria.
Esto es especialmente útil porque no necesito limitar cada agente individualmente. Puedo agrupar los procesos bajo un mismo presupuesto.
Para hacerlo utilicé systemd-run, que permite iniciar procesos dentro de unidades administradas por systemd.
Mi idea fue crear cuatro perfiles:
- Normal: 10 GB de memoria.
- Ligero: 6 GB.
- Pesado: 12 GB.
- Sin límite: ejecución normal, sin el límite adicional de esta función.
También quería que al abrir herdr apareciera un pequeño menú para seleccionar el perfil, pero sin afectar sus subcomandos habituales.
Así que preparé esta función de Bash:
herdr() {
  local bin; bin=$(command -v herdr) || { echo "herdr no encontrado"; return 1; }
  if [[ "$1" == "--sin-limite" ]]; then shift; "$bin" "$@"; return; fi
  if [[ $# -gt 0 ]] || pgrep -f "herdr server" >/dev/null; then "$bin" "$@"; return; fi
  local total_gb avail_gb def mem="${HERDR_MEM:-}" op
  total_gb=$(awk '/MemTotal/ {printf "%d", $2/1048576 + 0.5}' /proc/meminfo)
  avail_gb=$(awk '/MemAvailable/ {printf "%.1f", $2/1048576}' /proc/meminfo)
  def=$(( total_gb - 5 ))
  if [[ -z "$mem" ]]; then
    echo "RAM total: ${total_gb}G | disponible ahora: ${avail_gb}G"
    echo "  1) Normal ${def}G [Enter]  2) Ligero 6G  3) Pesado $(( total_gb - 3 ))G  4) Sin límite"
    read -r -t 10 -p "Límite de memoria para herdr: " op || echo
    case "$op" in
      ""|1) mem=$def ;; 2) mem=6 ;; 3) mem=$(( total_gb - 3 )) ;;
      4) "$bin"; return ;; *[!0-9]*) mem=$def ;; *) mem=$op ;;
    esac
  fi
  (( mem < 3 )) && mem=3
  systemd-run --user --scope --quiet \
    -p MemoryHigh=$(( mem - 1 ))G -p MemoryMax=${mem}G -p MemorySwapMax=2G "$bin"
}
En Fedora puedo guardar esta función dentro de ~/.bashrc.d/, sin necesidad de modificar directamente mi archivo .bashrc.
Ahora bien, hay tres propiedades que vale la pena entender.
MemoryHigh establece un umbral a partir del cual Linux comienza a ejercer presión para recuperar memoria y puede ralentizar los procesos.
MemoryMax establece un límite estricto. Si el grupo de procesos supera ese límite y no consigue recuperar suficiente memoria, Linux puede terminar procesos dentro del grupo.
Y MemorySwapMax establece cuánto espacio de swap puede utilizar ese conjunto de procesos.
En otras palabras, prefiero que un proceso de pruebas falle por alcanzar su presupuesto antes de que termine afectando todo mi escritorio.
Eso sí, hay una consideración importante.
El límite funciona sobre los procesos que realmente pertenecen al cgroup. Si herdr ya tiene un servidor ejecutándose fuera de ese grupo, iniciar un nuevo cliente no necesariamente moverá todo el servidor y sus agentes al nuevo límite.
Por eso la función comprueba si el servidor ya está funcionando y solamente solicita el perfil cuando se inicia la interfaz sin argumentos.
También conviene verificar que los procesos realmente hayan heredado el cgroup esperado.
Con esto tenía resuelta una parte del problema.
Pero todavía faltaba algo.
Limitar la memoria no significa que los agentes vayan a utilizarla de manera inteligente.
Segunda solución: limitar lo que pueden consumir las herramientas de Node.js
El siguiente paso fue configurar variables de entorno para Claude Code.
Dentro de ~/.claude/settings.json agregué:
{
  "env": {
    "NODE_OPTIONS": "--max-old-space-size=2048",
    "VITEST_MAX_THREADS": "2",
    "VITEST_MAX_FORKS": "2"
  }
}
Con esto buscaba dos cosas.
Primero, establecer un límite razonable para el heap de los procesos Node.js que heredaran esa configuración.
Segundo, reducir el paralelismo de Vitest.
¿Por qué elegí 2048 MB?
Porque tampoco quería establecer un límite tan pequeño que herramientas como TypeScript comenzaran a fallar constantemente.
Hay proyectos donde tsc necesita bastante memoria para analizar todos los tipos y dependencias.
Además, en mi proyecto utilizaba Vitest 1.6.1, donde estas variables corresponden a mecanismos de configuración del paralelismo de esa generación.
En versiones más recientes conviene configurar explícitamente los workers dentro de vitest.config.ts y comprobar que los valores se estén aplicando.
¿Y Jest?
Bueno, Jest no tiene una variable de entorno equivalente para establecer directamente la cantidad máxima de workers.
Por eso es necesario indicarlo mediante un argumento:
npx jest --maxWorkers=2Así evitamos que cada ejecución intente utilizar una cantidad excesiva de procesos.
Pero todavía quedaba un problema.
¿Qué pasa si el agente decide ejecutar un script que sobrescribe estas configuraciones?
Pues volvemos a estar en riesgo.
Así que necesitaba enseñarle a los agentes cómo quería que trabajaran.
Tercera solución: darle reglas de trabajo a mis agentes
Una de las ventajas de Claude Code es que podemos establecer instrucciones globales mediante un archivo CLAUDE.md.
Estas instrucciones permiten definir convenciones que los agentes deben considerar durante su trabajo.
Y se me ocurrió algo bastante simple.
Si tengo varios agentes trabajando en una laptop con memoria limitada, ¿por qué no indicarles que deben cuidar los recursos del equipo?
Así que agregué estas reglas en ~/.claude/CLAUDE.md:
## Recursos (laptop 16 GB, varios agentes en paralelo vía herdr)

- Corre solo los tests de los archivos que modificaste; nunca la suite completa ni coverage salvo que se pida.
- Jest siempre con `--maxWorkers=2`; Vitest con `--poolOptions.threads.maxThreads=2 --poolOptions.forks.maxForks=2`.
- Si un script de package.json fija su propio NODE_OPTIONS (p. ej. 8192), no lo uses en local: invoca jest/vitest directo.
- No dejes dev servers ni procesos en --watch corriendo al terminar.
- Antes de un tsc/build/coverage pesado, verifica con `free -h` que haya >3 GB disponibles.
Y aquí hay una diferencia que considero bastante importante.
Una cosa es limitar cuánto pueden consumir los agentes y otra es enseñarles cómo deberían consumirlo.
Con el cgroup puedo establecer un techo real de memoria.
Con las instrucciones puedo intentar evitar que un agente ejecute toda la suite de pruebas cuando solamente modificó un componente pequeño.
Por supuesto, estas instrucciones no son un mecanismo de seguridad infalible. Un agente podría ignorarlas o ejecutar un comando que no se comporte como esperamos.
Pero combinadas con los límites del sistema, permiten trabajar de una manera bastante más controlada.
Cuarta solución: proteger mi CI local
Aquí viene algo que fácilmente podría haber provocado otro incidente.
Como mencioné anteriormente, tengo un entorno de integración continua local con Jenkins, SonarQube y PostgreSQL.
La idea es bastante interesante.
Tengo un proceso que funciona como un vigía y revisa cada cinco minutos si existen nuevos commits en ramas feature/*, bugfix/* o hotfix/*.
Cuando encuentra cambios, puede lanzar un gate de validación.
El problema es que Jenkins estaba configurado con dos executors, lo que significa que podía ejecutar dos trabajos simultáneamente.
Y mis contenedores no tenían límites de memoria definidos.
Imagínate el escenario.
Tengo cuatro agentes trabajando.
Dos de ellos ejecutan pruebas.
Otro realiza un commit.
El vigía detecta el cambio y Jenkins comienza a ejecutar su pipeline.
De pronto tengo agentes, Jest, Vitest, TypeScript, Jenkins y otros procesos compitiendo por la memoria de la misma laptop.
¡OTRA VEZ EL MISMO PROBLEMA!
Además, había un detalle que inicialmente podría pasar desapercibido.
Aunque Jenkins tenga configurado un heap de Java mediante -Xmx1g, ese límite no controla automáticamente los procesos Node.js que el pipeline ejecuta.
Tampoco el límite de herdr controla los contenedores Docker, porque estos son gestionados por el demonio de Docker y sus propios cgroups.
Así que decidí agregar límites directamente en Docker Compose.
Para Jenkins:
mem_limit: ${JENKINS_MEM_LIMIT:-6g}Para SonarQube:
mem_limit: ${SONAR_MEM_LIMIT:-3g}Y para su PostgreSQL:
mem_limit: ${SONAR_DB_MEM_LIMIT:-512m}Cada una de estas propiedades corresponde al servicio respectivo dentro de su archivo Compose.
También reduje la cantidad de executors de Jenkins:
numExecutors: ${JENKINS_EXECUTORS:-1}Y dentro del pipeline agregué las variables de entorno necesarias para controlar el paralelismo de Vitest:
withEnv(["VITEST_MAX_THREADS=2", "VITEST_MAX_FORKS=2"]) {
    // Ejecución de las pruebas del frontend
}
Jest ya tenía configurado --maxWorkers=2 en el gate, así que no necesitaba duplicar ese ajuste.
Con esto conseguí establecer presupuestos independientes para los agentes y para los servicios del CI.
Aunque también hay que tener cuidado con algo: si el límite del contenedor es demasiado bajo, el pipeline puede terminar siendo finalizado por falta de memoria.
Por ejemplo, un proceso que termina con el código 137 recibió una señal SIGKILL. Una de las causas posibles es que el contenedor haya alcanzado su límite de memoria.
En esos casos toca revisar los registros, confirmar si hubo un OOM y decidir si necesitamos aumentar el presupuesto o reducir el consumo de las pruebas.
La idea no es establecer límites arbitrariamente pequeños.
La idea es controlar el consumo sin impedir que las herramientas hagan correctamente su trabajo.
Y de paso, también tuve que revisar KDE y Chrome
Mientras investigaba todo esto encontré otro detalle curioso.
Baloo, el indexador de archivos de KDE Plasma, estaba revisando aproximadamente 200.000 archivos.
Y entre ellos estaban mis directorios node_modules.
Si trabajas con proyectos JavaScript seguramente sabes lo que eso significa.
Un solo proyecto puede tener miles de archivos dentro de sus dependencias. Ahora imagínate varios worktrees del mismo monorepo.
Pues sí, también estaba desperdiciando recursos indexando archivos que realmente no necesitaba encontrar desde el buscador del escritorio.
Así que decidí excluir mis proyectos de Baloo:
balooctl6 config add excludeFolders ~/Documentos/ProyectosTambién activé el modo Ahorro de memoria de Chrome desde:
chrome://settings/performancePorque claro, de nada sirve optimizar los agentes si al mismo tiempo tengo decenas de pestañas consumiendo varios gigabytes.
Otra mejora que dejé como posibilidad fue cambiar el algoritmo de compresión de zram de lzo-rle a zstd.
zstd puede conseguir mejores niveles de compresión en determinados escenarios, aunque también tiene un costo de procesamiento que vale la pena medir.
No quería comenzar a modificar todo el sistema sin saber cuánto beneficio real iba a conseguir.
¿Y si el problema también está en la configuración del proyecto?
Hasta ahora había aplicado límites a mi entorno de desarrollo, pero también entendí algo.
Si mañana otro desarrollador clona el repositorio y ejecuta las mismas pruebas, podría encontrarse con un problema parecido.
Por eso considero que parte de la solución también debe estar dentro del propio proyecto.
Por ejemplo, en Vitest 1.x podemos configurar el número máximo de workers mediante poolOptions:
export default defineConfig({
  test: {
    poolOptions: {
      threads: {
        maxThreads: 2,
        minThreads: 1,
      },
      forks: {
        maxForks: 2,
        minForks: 1,
      },
    },
  },
});
De esta manera, el límite no depende únicamente de las variables de entorno de mi laptop.
También conviene revisar los scripts de coverage que establecen límites de memoria excesivos.
En el backend, otra alternativa que vale la pena evaluar es utilizar @swc/jest en lugar de ts-jest, o revisar opciones como isolatedModules, dependiendo de la versión y de cómo esté configurado el proyecto.
En el frontend también se puede evaluar happy-dom como alternativa a jsdom.
No significa que estas herramientas sean automáticamente mejores para todos los proyectos. Algunas pueden ofrecer menor consumo o mayor velocidad, pero también existen diferencias de compatibilidad.
Lo correcto sería probarlas, medir los resultados y decidir en función de las necesidades reales.
¿Esto solamente pasa con Node.js?
Esta fue otra pregunta que me hice después de terminar la investigación.
Porque si el problema era el paralelismo de las herramientas de desarrollo, entonces probablemente podría encontrar situaciones similares trabajando con Java, Python, Go, Rust o cualquier otro ecosistema.
Y efectivamente, cada stack tiene sus propias particularidades.
Por eso preparé una comparativa aproximada pensando en una laptop de 16 GB, con unos 10 GB reservados para los agentes.
Los valores son estimaciones orientativas para proyectos medianos, no resultados de benchmarks controlados. El escenario de Node.js es el que está relacionado directamente con mi incidente.
| Stack tecnológico | Pico por agente | Sin optimizar | Agentes recomendados |
|---|---|---|---|
| Python + FastAPI + pytest | 0,1–0,5 GB | 1–3 GB | 6 o más |
| PHP + Laravel | 0,2–0,5 GB | 1–2 GB | 5–6 |
| Go | 0,3–1,5 GB | 2–3 GB | 5 |
| Java 21 + Spring Boot | 1,5–3 GB | 4–8 GB | 3 |
| Node + NestJS + Jest | 1,5–2,5 GB | 5–8 GB | 3–4 |
| React + Vite + Vitest | 1–2 GB | 4–8 GB | 3–4 |
| .NET | 1–3 GB | 3–5 GB | 3 |
| Flutter / Android | 2–4 GB | 4–6 GB | 2 |
| Rust | 2–6 GB | 8 GB o más | 2 |
| Playwright E2E | 1–3 GB | 4–6 GB | 1 |
Estos valores consideran los límites aplicados y el CI local apagado. Si levanto Jenkins y SonarQube, tengo que reducir la cantidad de agentes.
Hay algunas cosas interesantes que podemos observar.
Python, PHP y Go suelen ser bastante cómodos para trabajar con varios agentes cuando las tareas son moderadas. Evidentemente, si comenzamos a utilizar bibliotecas de procesamiento de datos, modelos de machine learning o compilaciones exigentes, la historia puede cambiar.
Java puede necesitar bastante memoria, especialmente con Maven, pruebas de integración y Testcontainers. Pero tenemos herramientas bastante conocidas para controlar el heap de las JVM mediante -Xmx, aunque eso no limita absolutamente toda la memoria del proceso.
Node.js puede resultar particularmente engañoso. Un servidor de desarrollo puede consumir relativamente poco, pero cuando comenzamos a ejecutar pruebas, compilaciones y herramientas de análisis estático, el consumo puede crecer considerablemente.
Rust y Flutter/Android pueden presentar picos bastante elevados durante las compilaciones, por lo que preferiría trabajar con menos agentes simultáneos en una laptop como la mía.
Y si hablamos de pruebas E2E con Playwright, definitivamente no dejaría que todos mis agentes ejecuten navegadores al mismo tiempo.
También existen mecanismos específicos para limitar el paralelismo en cada ecosistema.
Por ejemplo, en Go podemos utilizar -p 2, en Rust CARGO_BUILD_JOBS=2, en Maven configurar la memoria de las JVM y en Playwright utilizar --workers=1.
Al final, cada tecnología tiene sus propias herramientas para controlar el consumo.
Lo importante es conocerlas antes de comenzar a multiplicar ejecuciones.
¿En qué situaciones podría volver a quedarme sin memoria?
Después de todo esto me di cuenta de que el incidente no era tan excepcional como parecía.
De hecho, existen bastantes situaciones en las que podría volver a ocurrir.
Por ejemplo, si varios agentes ejecutan pruebas completas al mismo tiempo, especialmente cuando trabajan en diferentes worktrees.
También si alguno decide ejecutar coverage para verificar un cambio pequeño, o si un script de npm establece su propio límite de memoria e ignora la configuración global.
Otro caso bastante común sería ejecutar tsc --noEmit y ESLint simultáneamente sobre un monorepo grande.
Y ni hablar de que Jenkins comience a ejecutar un gate justo cuando los agentes están realizando commits.
También tendría que prestar atención a Playwright, porque cada navegador y sus workers necesitan memoria adicional.
En proyectos Java, Testcontainers podría levantar bases de datos y otros servicios dentro de Docker, fuera del límite de mi terminal.
Otro problema bastante sencillo de olvidar son los procesos que quedan funcionando después de terminar una tarea.
Un servidor de desarrollo, un proceso --watch o una ejecución de Vitest que nunca se cerró.
Y si varios agentes comienzan a ejecutar npm ci o composer install al mismo tiempo, también pueden aparecer picos importantes de consumo.
Todo esto sin contar Chrome, SonarQube, MySQL, Redis y los demás servicios que normalmente utilizamos mientras desarrollamos.
Es decir, aunque haya solucionado el incidente original, todavía necesito administrar la concurrencia de mi entorno de trabajo.
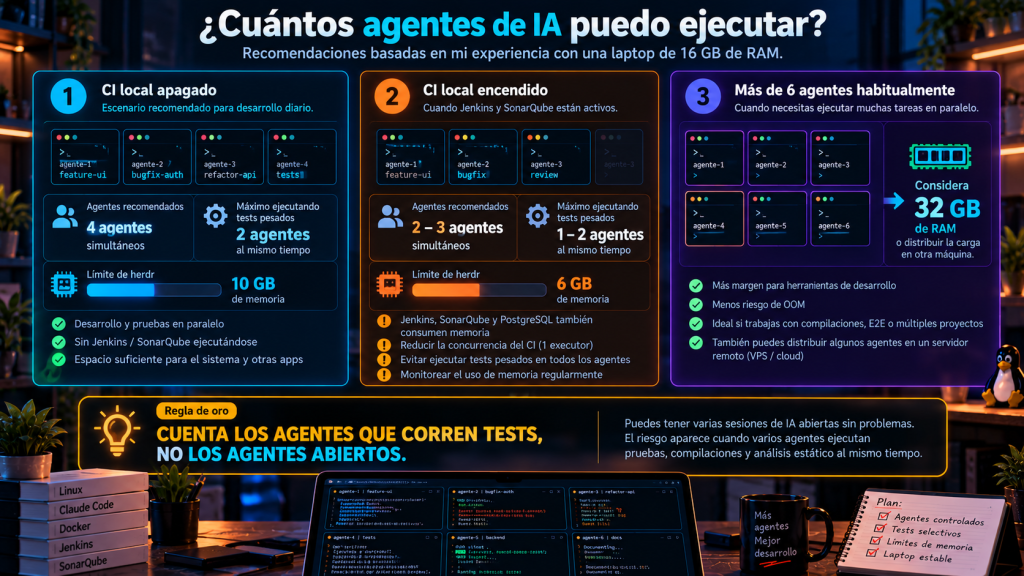
Entonces, ¿cuántos agentes debería utilizar?
Después de toda esta experiencia decidí establecer algunas reglas personales.
No quería dejar de utilizar múltiples agentes, porque realmente encuentro bastante valor en este flujo de trabajo.
Pero tampoco quería seguir trabajando bajo la idea de que mientras más agentes tuviera abiertos, más productivo sería.
Así que terminé definiendo este pequeño estándar para mi laptop:
| Situación | Agentes simultáneos | Límite de herdr |
|---|---|---|
| CI local apagado | 4 agentes | Normal: 10 GB |
| CI local encendido | 2–3 agentes | Ligero: 6 GB |
| Más de 6 habitualmente | Evaluar 32 GB de RAM | Según la carga |
Pero hay una condición importante.
Cuando tengo cuatro agentes abiertos, procuro que como máximo dos estén ejecutando pruebas pesadas al mismo tiempo.
Los otros pueden estar leyendo código, preparando modificaciones, investigando o realizando tareas que no requieran tanta memoria.
Y creo que esta es la lección más importante de toda la experiencia.
NO CUENTES LOS AGENTES QUE TIENES ABIERTOS. CUENTA LOS AGENTES QUE ESTÁN EJECUTANDO PRUEBAS.
Porque puedo tener seis sesiones de Claude Code abiertas sin que necesariamente exista un problema.
Pero si tres o cuatro comienzan a ejecutar suites completas, compilaciones y análisis estático al mismo tiempo, la situación cambia completamente.
Y si algún día necesito trabajar habitualmente con más de seis agentes ejecutando tareas exigentes, probablemente lo más razonable sea ampliar mi equipo a 32 GB de RAM o distribuir parte de esas ejecuciones en otra máquina.
Aunque incluso con más memoria seguiría siendo necesario controlar el paralelismo.
Algunas cosas que ahora reviso antes de abrir varios agentes
Después del incidente terminé adoptando una pequeña lista de verificación:
- Revisar cuánta RAM y swap tengo disponibles.
- Iniciar herdr con el perfil de memoria adecuado.
- Confirmar que Jest y Vitest tengan límites de workers.
- Evitar que los agentes ejecuten suites completas innecesariamente.
- Revisar que los scripts no sobrescriban los límites de Node.js.
- Comprobar si Jenkins, SonarQube y Docker están ejecutándose.
- Cerrar servidores de desarrollo y procesos que ya no necesito.
- Revisar los registros OOM si encuentro cierres inesperados.
No es que tenga que ejecutar manualmente toda esta lista cada cinco minutos.
La idea es que mi entorno de desarrollo tenga configuraciones que reduzcan estos riesgos desde el principio.
Y que los agentes también conozcan las restricciones bajo las cuales están trabajando.
Finalmente, ¿qué aprendí de todo esto?
Creo que una de las cosas que más me entusiasma de los agentes de inteligencia artificial es la posibilidad de delegar trabajo de una manera que antes no era tan sencilla.
Puedo tener un agente implementando una funcionalidad, otro revisando errores y otro preparando pruebas, mientras yo me concentro en decisiones de arquitectura o en revisar los resultados.
Y eso me parece increíble.
Pero también me hizo darme cuenta de algo.
Antes, cuando desarrollaba una funcionalidad, normalmente era yo quien decidía cuándo ejecutar las pruebas, cuándo compilar y cuándo levantar determinados servicios.
Ahora tengo varios agentes capaces de tomar esas decisiones de manera independiente.
Y aunque cada uno pueda estar haciendo correctamente su trabajo, eso no significa que el conjunto esté utilizando los recursos de manera eficiente.
Es bastante parecido a lo que ocurre en los sistemas distribuidos.
Podemos tener varios servicios funcionando perfectamente por separado, pero cuando todos comienzan a solicitar los mismos recursos sin ningún tipo de coordinación, aparecen los problemas.
Y eso fue exactamente lo que me pasó.
No necesitaba abandonar Claude Code, dejar de utilizar herdr o cambiar de sistema operativo.
Necesitaba entender qué estaba ocurriendo, identificar los procesos responsables y establecer límites razonables.
Al final terminé aprendiendo bastante más sobre Linux, cgroups, zram, Node.js, Vitest y Jest de lo que originalmente tenía planeado.
Y todo porque quería tener unos cuantos agentes más trabajando en mi laptop. Jajaja.
Supongo que esa es una de las cosas que más me gustan del desarrollo de software.
A veces comenzamos intentando resolver un problema aparentemente pequeño y terminamos aprendiendo cómo funcionan varias tecnologías que utilizamos todos los días.
La inteligencia artificial puede multiplicar nuestra capacidad de desarrollo, pero también puede multiplicar nuestro consumo de recursos.
Y si vamos a trabajar con varios agentes autónomos, creo que debemos comenzar a administrar nuestros entornos de desarrollo con la misma seriedad con la que administraríamos cualquier otro sistema.
Porque al final no se trata de cuántos agentes podemos abrir.
Se trata de cuántos podemos hacer trabajar correctamente al mismo tiempo.
Y bueno, esa fue mi experiencia. Espero que te sirva si también estás comenzando a trabajar con varios agentes de IA y de pronto notas que tu laptop ya no da para más.
¡Nos vemos en una próxima historia!